[세특 S코드] 컴공과 통계학의 혼혈? '데이터사이언스학과' 합격은 '확통'과 '행렬'이 결정한다!
컴공과 통계학의 혼혈? 데이터사이언스 합격은 '확통'과 '행렬'이 결정한다
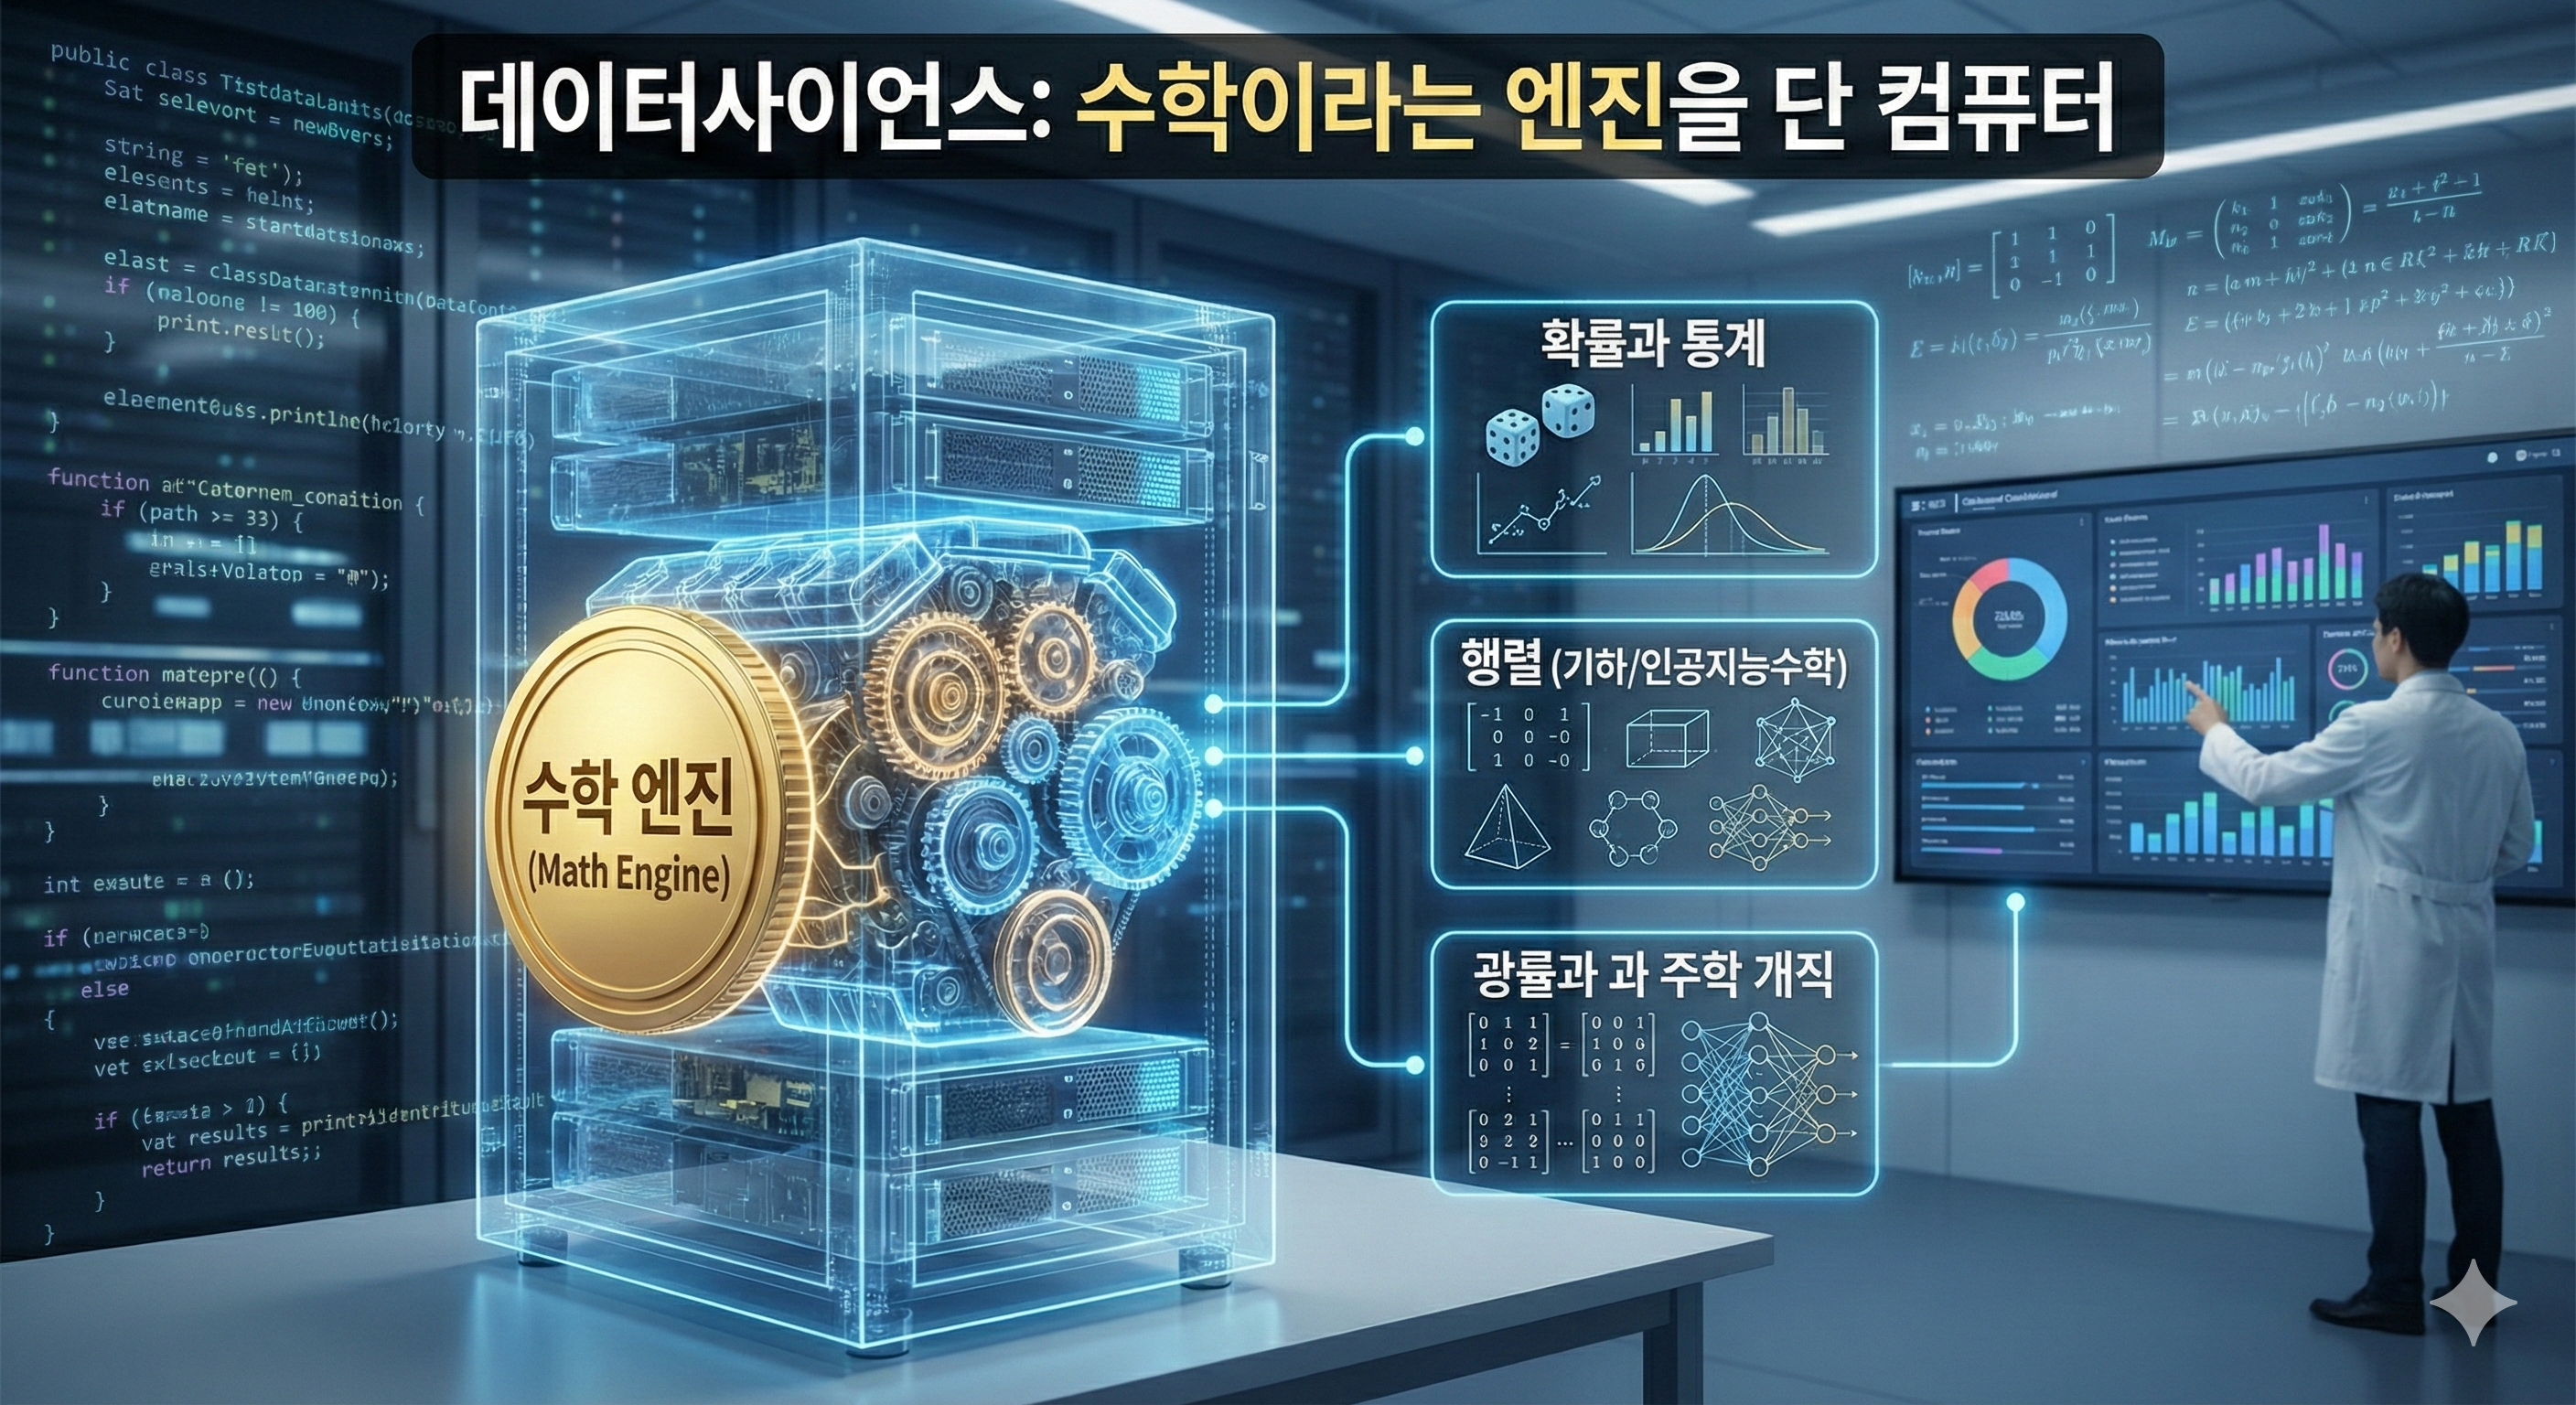
도입부
"빅데이터 전문가가 되고 싶어요."
4차 산업혁명의 핵심 키워드인 만큼, 데이터사이언스학과(또는 인공지능응용학과)의 인기는 하늘을 찌릅니다. 하지만 많은 학생들이 컴퓨터공학과(CS)와 통계학과(Statistics) 사이에서 정체성을 찾지 못하고 방황합니다.
코딩을 잘하면 컴공을 가고, 수학을 잘하면 통계학을 가라는데, 데이터사이언스는요? 정답은 "데이터를 컴퓨터 언어(Python)로 다루되, 통계적 사고(Statistics)로 해석하는 능력"을 동시에 보여줘야 합니다.
화려한 워드 클라우드(Word Cloud) 하나 그려놓고 "빅데이터 분석했다"고 우기면 광탈입니다. 그 데이터 속에 숨겨진 상관관계와 인과관계를 수학적으로 증명해 내는 학생만이 합격증을 거머쥘 수 있습니다.
1. [Core Strategy] 합격의 8할, 수학과 과학에서 판가름 난다
데이터사이언스는 '수학'이라는 엔진을 단 '컴퓨터'입니다. 확률과 통계, 그리고 행렬(기하/인공지능수학)이 핵심입니다.
① 확률과 통계 : 베이즈 정리와 추론
- 교과 개념: 조건부 확률, 베이즈 정리, 확률분포, 가설 검정
- Killer Topic: [베이즈 정리(Bayes' Theorem)를 활용한 데이터 업데이트와 예측 모델 보정]
- 심화 가이드: 전통적인 통계(빈도주의)를 넘어, 데이터가 추가될 때마다 확률을 업데이트하는 베이지안 통계의 관점을 보여주십시오. 사전 확률(Prior)이 새로운 데이터(Likelihood)를 만나 사후 확률(Posterior)로 변하는 과정을 수식으로 설명하고, 이를 스팸 메일 필터나 질병 진단 예측 알고리즘에 적용해 본다면 전공 적합성 200%입니다.
② 기하 / 인공지능 수학 : 차원 축소와 행렬
- 교과 개념: 벡터의 내적, 행렬의 연산, 정사영
- Killer Topic: [주성분 분석(PCA)을 이용한 고차원 데이터의 시각화 및 특징 추출]
- 심화 가이드: 데이터가 복잡하다는 건 '변수(차원)'가 많다는 뜻입니다. 수십 개의 변수를 가진 데이터를 2~3개의 핵심 성분으로 압축하는 PCA(Principal Component Analysis)의 원리를 선형대수학(고윳값 분해)으로 설명하십시오. 데이터의 분산(Variance)을 최대한 보존하는 축을 찾는 과정이 기하학적 정사영과 어떻게 연결되는지 탐구해야 합니다.
③ 정보 / 미적분 : 최적화와 경사 하강법
- 교과 개념: 도함수, 함수의 극솟값, 알고리즘
- Killer Topic: [손실 함수(Loss Function) 최소화를 위한 경사 하강법(Gradient Descent) 알고리즘 구현]
- 심화 가이드: 데이터 분석의 목적은 오차를 줄이는 모델을 만드는 것입니다. 오차 함수를 미분하여 기울기가 0이 되는 지점을 찾아가는 과정을 시각화하십시오. 학습률(Learning Rate)을 조절해가며 전역 최적해(Global Minimum)에 도달하는지, 지역 최적해(Local Minimum)에 빠지는지 실험하고 분석한 리포트는 매우 강력합니다.
2. [Differential Strategy] '전공자'의 한계를 깨는 융합 전략
데이터는 그 자체로는 의미가 없습니다. 사회, 경제, 바이오 등 도메인(Domain) 지식과 결합될 때 비로소 가치가 생깁니다.
▶사회문제 탐구 / 국어 : 텍스트 마이닝(Text Mining)
- 주제: [TF-IDF 알고리즘을 활용한 뉴스 댓글 여론 분석과 키워드 네트워크 시각화]
- 전략: 단순히 빈도수만 세는 것은 초보입니다. 단어의 중요도를 가중치로 계산하는 TF-IDF(Term Frequency-Inverse Document Frequency) 기법을 적용하여, 특정 이슈에 대한 여론이 긍정인지 부정인지 분류(Sentiment Analysis)하는 프로젝트를 수행하십시오.
▶경제 / 통합사회 : 상관관계와 인과관계
- 주제: [공공 데이터를 활용한 부동산 가격 변동 요인 분석과 '가짜 상관관계'의 오류 고찰]
- 전략: "아이스크림 판매량이 늘면 익사 사고가 는다"는 식의 단순 상관관계를 인과관계로 착각하는 오류(Spurious Correlation)를 지적하십시오. 금리, 인구수 등 다양한 변수 중 실제 집값에 영향을 미치는 요인을 회귀 분석(Regression)으로 찾아내는 통계적 엄밀함을 보여주십시오.
3. [Connection] 고교 vs 대학, 배움의 연결고리
'확률과 통계' 시간이 여러분에게는 전공 기초 수업입니다.
1. 고교 확률과 통계 (통계적 추정) $\rightarrow$ 데사과 수리통계학 (Mathematical Statistics)
- (설명) 표본 평균, 분산, 표준편차의 개념을 넘어 중심극한정리(CLT)와 최우추정법(MLE) 등 통계적 추론의 엄밀한 증명 학습.
2. 고교 기하 (행렬/벡터) $\rightarrow$ 데사과 선형대수학 (Linear Algebra)
- (설명) 빅데이터는 곧 행렬(Matrix)입니다. 행렬의 분해(SVD, QR)와 연산을 통해 대용량 데이터를 처리하고 압축하는 기법 연구.
3. 고교 정보 (데이터 관리) $\rightarrow$ 데사과 데이터베이스 / 데이터 마이닝
- (설명) 정형/비정형 데이터를 효율적으로 저장(SQL/NoSQL)하고, 그 속에서 유의미한 패턴을 찾아내는 알고리즘 개발.
4. [Workflow] 합격 3년 로드맵
▶1학년 [데이터 리터러시]:
- 엑셀(Excel)부터 마스터하십시오. 통계청이나 공공데이터포털에서 데이터를 다운로드해 그래프를 그려보고, 데이터가 왜곡될 수 있는 사례(통계의 함정)를 찾아보며 데이터를 비판적으로 읽는 눈을 기르십시오.
▶2학년 [도구 습득과 분석]:
- 파이썬(Python)이나 R 언어의 기초를 익혀 '판다스(Pandas)' 라이브러리로 데이터를 전처리(Pre-processing)하는 경험을 하십시오. 결측치(빈 값)를 어떻게 채울지 고민하고, 간단한 상관분석을 통해 가설을 검증해 봐야 합니다.
▶3학년 [예측 모델링]:
- 과거 데이터를 분석하는 것을 넘어 미래를 예측하십시오. "학교 매점 매출 예측", "날씨에 따른 미세먼지 농도 예측" 등 시계열 데이터나 회귀 분석을 활용한 미니 프로젝트를 수행하고, 예측의 정확도($R^2$)를 평가하십시오.
5. [Checklist] 합격 자가진단 리스트
- [ ] 확률과 통계 교과목 성적이 최상위권이며, 세특 내용이 깊이 있는가?
- [ ] 데이터를 분석할 때 '전처리(Cleaning)' 과정에 대한 고민과 해결책이 기록되었는가? (가장 중요)
- [ ] 단순히 그래프만 그린 것이 아니라, 통계적 검정(t-test 등)을 통해 유의성을 증명했는가?
- [ ] 행렬(Matrix)과 벡터(Vector)가 데이터 분석에 어떻게 쓰이는지 이해하고 있는가?
- [ ] 인문/사회 계열 과목에서도 데이터를 근거로 주장을 펼치는 습관이 보이는가?
6. [Q&A] 현직 컨설턴트의 팩트 (Best 5)
Q1. 컴퓨터공학과, 통계학과, 데이터사이언스학과 중 어디가 좋나요?
A. 시스템 개발을 하고 싶으면 컴공, 이론적 통계 모델을 연구하고 싶으면 통계, 데이터로 비즈니스 문제를 해결하고 싶으면 데사과입니다. 최근 트렌드는 데사과가 융합적이라 취업 폭이 넓지만, 깊이는 컴공이나 통계가 더 깊을 수 있으므로 커리큘럼을 확인하세요.
Q2. 문과생이 교차지원하기 좋은가요?
A. 가장 좋습니다. 데이터 분석은 경영, 경제, 심리, 사회학 등 문과적 도메인 지식이 필수적입니다. 단, '확통'만큼은 이과생 뺨치게 잘해야 합니다. 문과생의 인문학적 통찰력에 통계적 스킬을 얹으면 최고의 인재가 됩니다.
Q3. 코딩 실력, 얼마나 중요해요?
A. 앱을 만드는 수준의 코딩이 아니라, 데이터를 핸들링하는 코딩(SQL, Python, R) 능력이 중요합니다. 화려한 인터페이스보다 논리적인 데이터 처리 스크립트를 짜는 능력을 봅니다.
Q4. 수학 세특에 뭘 써야 할까요?
A. '선형대수학(Linear Algebra)'의 기초입니다. 행렬의 곱셈이 데이터의 변환을 의미한다는 점, 고윳값이 데이터의 특징을 나타낸다는 점 등을 기하/인공지능 수학 세특에 녹여내십시오.
Q5. 추천 도서가 있나요?
A. <신호와 소음>은 필독서입니다. 데이터 속에서 진짜 신호(Signal)와 가짜 소음(Noise)을 구분하는 통계적 사고방식을 배울 수 있습니다. 기술적인 책으로는 <파이썬 라이브러리를 활용한 데이터 분석> 등을 참고해 실습해 보는 것을 추천합니다.
7. [Expert's Advice] 합격 선배의 원포인트 레슨
"처음엔 머신러닝 모델 돌리는 게 멋있어 보여서 그것만 했어요. 그런데 면접관님이 '데이터의 결측치(Missing Value)는 어떻게 처리했나?'라고 물으시더군요. 그때 깨달았죠. 화려한 AI 모델보다 중요한 건 쓰레기 데이터(Garbage In)를 걸러내는 전처리 과정(Garbage Out)이라는 것을요. 그 뒤로는 데이터 클리닝 과정을 세특에 꼼꼼히 적었습니다."
- S대 데이터사이언스대학원 합격생(학부 통계학) L군
8. [Outro] 마치며
21세기의 원유는 데이터라고 합니다. 하지만 원유도 정제하지 않으면 쓸모없는 검은 액체일 뿐입니다.
데이터사이언스학과는 데이터를 정제하고 가공하여 '인사이트'라는 보석을 캐내는 곳입니다. 컴퓨터의 기술과 통계학의 지혜를 양손에 쥔 여러분만이 이 빅데이터의 바다를 항해할 수 있습니다.
입시CUBE가 여러분의 나침반이 되겠습니다.
#데이터사이언스학과 #빅데이터학과 #통계학과 #컴퓨터공학 #확통세특 #베이즈정리 #PCA #선형대수학 #텍스트마이닝 #입시컨설팅 #인공지능수학 #정보세특 #행렬세특 #파이썬데이터분석 #입시큐브 #수시등급 #학종전략 #세특주제 #회귀분석 #데이터리터러시
'아카이브 > -[세특 시크릿 코드]' 카테고리의 다른 글
| [세특S코드] 코딩만 잘하면 개발자? '수학' 못하면 평생 '코더'로 산다 - <소프트웨어학과> (0) | 2026.03.17 |
|---|---|
| [세특 S코드] 물로켓 쏘고 "우주가 꿈"이라 적지 마라... 합격은 '궤도 역학'과 '충격파'에 있다 - '우주항공공학과' (0) | 2026.02.12 |
| [세특 S코드] 지구를 구하는 건 '착한 마음'이 아니라 '미적분'이다... 에너지공학 합격 전략 (0) | 2026.02.03 |
| [세특 S코드] 자동차 덕후? 이제는 '움직이는 스마트폰' 개발자다! (0) | 2026.02.01 |
| [세특 S코드] 기계공학, '로봇 덕후'는 떨어지고 '역학(Mechanics) 변태'가 합격한다 (0) | 2026.01.29 |


댓글